Méthode Agentic Engineering
Une partie de ce site est réalisée en agentic engineering : le code est écrit par un agent IA, Claude Code. Pas n'importe comment, mais selon la méthode décrite par le schéma ci-dessous, où les étapes automatiques alternent avec des validations humaines. Les agents IA sont en revanche moins utilisés pour le traitement des données, afin d'en garder la maîtrise.
Huit étapes, quatre validations humaines
Chaque ticket suit le même parcours, outillé par le plugin ds (dépôt privé ds-dev-claude) : des skills et des sous-agents communs à tous les dépôts. L'agent propose et exécute ; l'humain décide aux quatre points marqués.
- Validation humaine : rien ne continue sans la décision de l'humain.
- Agent IA : Claude Code ou un sous-agent travaille, contrôlé par des tests et une relecture.
- Automatique : la CI et le déploiement s'enchaînent sans intervention.
- Plan et itération avec l'humain. L'agent reformule la demande et propose un plan court, critère par critère ; un sous-agent challengeur le relit et peut le bloquer. L'humain tranche les désaccords et valide le plan.
- Ajout au Backlog. L'agent rédige le ticket GitHub avec des critères d'acceptation vérifiables. L'humain le relit et décide de l'ajouter au backlog du kanban.
- Développement. L'agent écrit d'abord un test qui échoue, puis le code qui le fait passer, sur une branche dédiée. Un sous-agent relecteur relit la branche, puis la CI est rejouée en local et sur GitHub Actions.
- Revue de la PR. L'agent ouvre la pull request avec le résultat de ses vérifications. L'humain relit le diff, valide et fusionne : l'agent ne fusionne jamais.
- CI automatique. GitHub Actions rejoue les tests des parties touchées et, s'ils passent, fait avancer la branche de production. Un échec bloque la promotion, sans intervention.
- Déploiement automatique. Coolify déploie la branche de production sur le serveur, puis la CI vérifie que le site répond. Personne n'intervient, sauf incident.
- Mise à jour de la documentation et des ADR. Après la promotion, une tâche cloud confiée à un agent met à jour la documentation et les décisions d'architecture (ADR) dans une PR dédiée. La documentation suit ainsi le code réellement livré.
- Clôture du ticket avec post-mortem. L'agent publie un retour d'itération sur le ticket, et un post-mortem après un incident. L'humain le relit et clôt le ticket : chaque retour améliore la méthode.
Monitoring
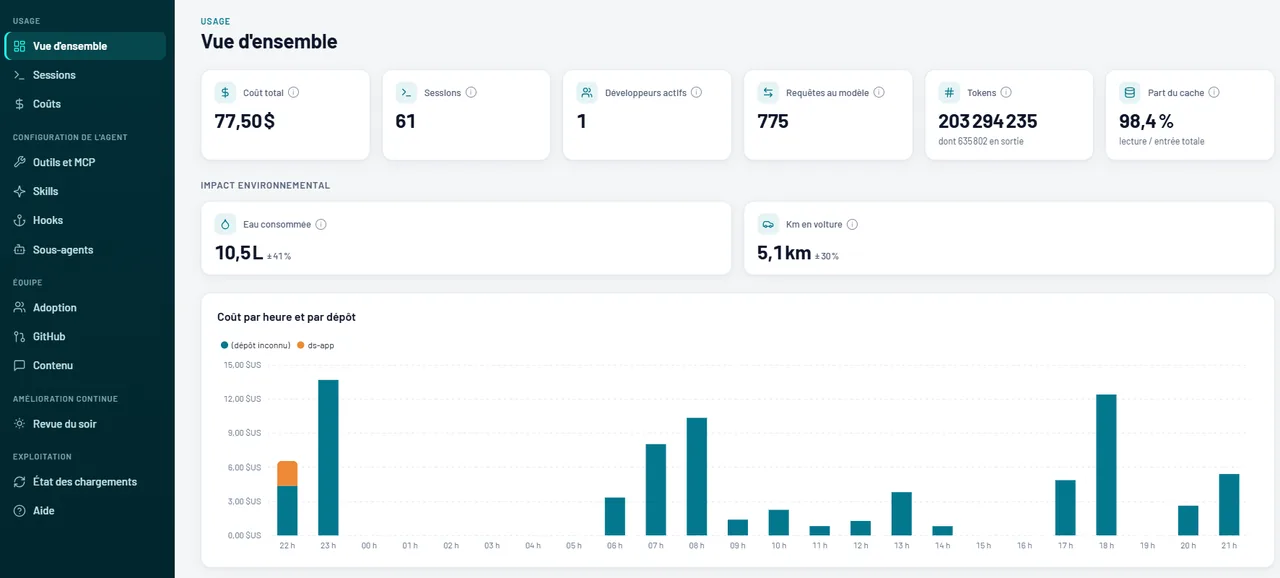
ds-codeagent-insightsCode Agent Insights mesure l'usage des agents de code dans une équipe de développement. Sa collecte s'appuie sur la télémétrie native de Claude Code, sans agent à installer, et la croise avec GitHub.
Ce qui vient de GitHub
- Les dépôts suivis.
- Les commits et PR co-signés par Claude, rattachés aux sessions qui les ont produits.
- Les fichiers de configuration
.claude/: skills, agents, hooks (leurs noms, pas leur contenu). - Les post-mortems (
docs/postmortems/) : prévus.
Ce qui est mesuré
- Le suivi de l'usage : coût, tokens, outils et serveurs MCP, skills, hooks, adoption par l'équipe.
- La classification des prompts par type de tâche : un LLM range chaque demande (nouvelle fonctionnalité, correction, tests…) dans une catégorie. Seule cette catégorie entre dans les indicateurs, jamais le texte du prompt.
- L'impact environnemental estimé de l'usage.
- Des recommandations sur la façon de travailler, issues de la revue du soir des sessions.